次世代のビジネスをつくる、実装と教育のメディア。
検索メニュー
キーワードで探す
AIに質問すると、すぐに答えが返ってくることもあれば、「考えています…」としばらく待たされてから答えが返ってくることもあります。この違いをつくっているのが、推論モデルです。
同じ生成AIでも、答える前に“じっくり考える”ものと、“パッと即答する”ものがあります。この違いを知らないと、複雑な作業を非推論モデルに任せて精度を落としたり、単純な作業に重い“考えるモード”を使って待たされたり、料金がかさんだりします。
この記事では、推論モデルの仕組みを内部構造まで踏み込んで解説したうえで、ChatGPT・Gemini・Claude・Copilotでの切り替え方までを整理します(情報は2026年10月時点)。
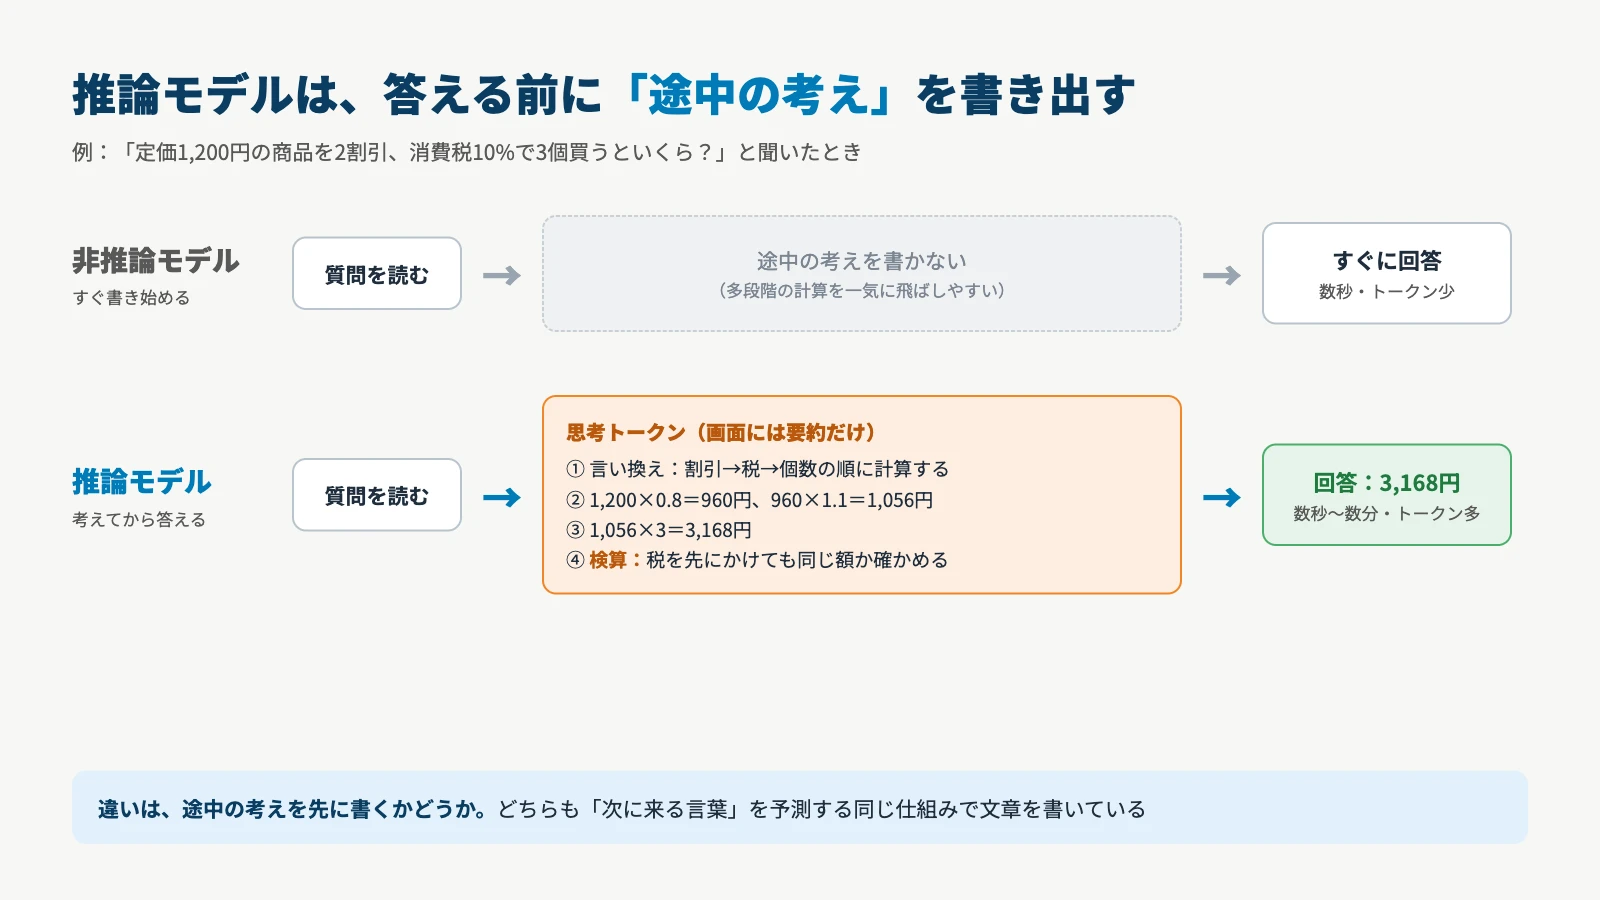
推論モデル(英語で reasoning model。「リーズニングモデル」「思考モデル」とも呼ぶ)とは、最終的な答えを出す前に、段階的な「考える過程」を長めに生成してから答えを組み立てるAIのことです。対して、その工程を挟まずにすぐ返すのが非推論モデルです。
生成AIは、文章を「次に来る言葉」の確率予測でつむいでいます(くわしくは生成AIは「考えて」いない)。非推論モデルは、その予測でいきなり答えを書き始めます。だから数式やバグ調査のような多段階の問題では、途中の論理を飛ばして“早合点”し、もっともらしいけれど間違った結論を出しがちです。
推論モデルは、答える前に「問題を言い換える → 方針を立てる → 計算する → 検算する」といった途中の考えを大量に書き出し、そのうえで最終回答を組み立てます。同じ「次の言葉を予測する」仕組みの上で、“いきなり答える”か“考えてから答える”かの違いです。
| 非推論モデル | 推論モデル | |
|---|---|---|
| 答えるまでの流れ | 質問を読んで、すぐに回答を書き始める | 質問を読んで、まず「考える過程」を書き出し、そのあと回答を書く |
| 速さ | 数秒 | 数秒〜数分(難しいほど長い) |
| 料金・使用量 | 少ない | 多い(考えた分もトークンとして数えられる) |
| 得意なこと | 要約・下書き・アイデア出し・分類 | 数学・複雑な分析・プログラムの不具合調査・条件の漏れ探し |
| 苦手なこと | 多段階の論理、検算が必要な問題 | 単純な作業(待たされるだけで割高になる) |
以前は、プロンプトで「ステップバイステップで考えて」と人間が指示して、途中の考えを書かせていました。推論モデルは、この動きを指示されなくても自分でやるように訓練したものです。
この方向を最初に製品化したのが、OpenAIが2024年9月に発表した「o1」です。数学やプログラミングで従来モデルを大きく上回り、2025年1月には中国のDeepSeekが、作り方を論文で公開した「DeepSeek-R1」を発表しました。いまでは、ChatGPT・Gemini・Claude・Copilotのいずれもが「考える」モードを標準で備えています。
推論モデルの中身は、まったく新しい種類のAIではありません。ふつうのLLMに、「考えてから答える」振る舞いを追加の学習で身につけさせたものです。ここでは、作り方を論文で詳しく公開しているDeepSeek-R1を主な例に、その仕組みを分解します。
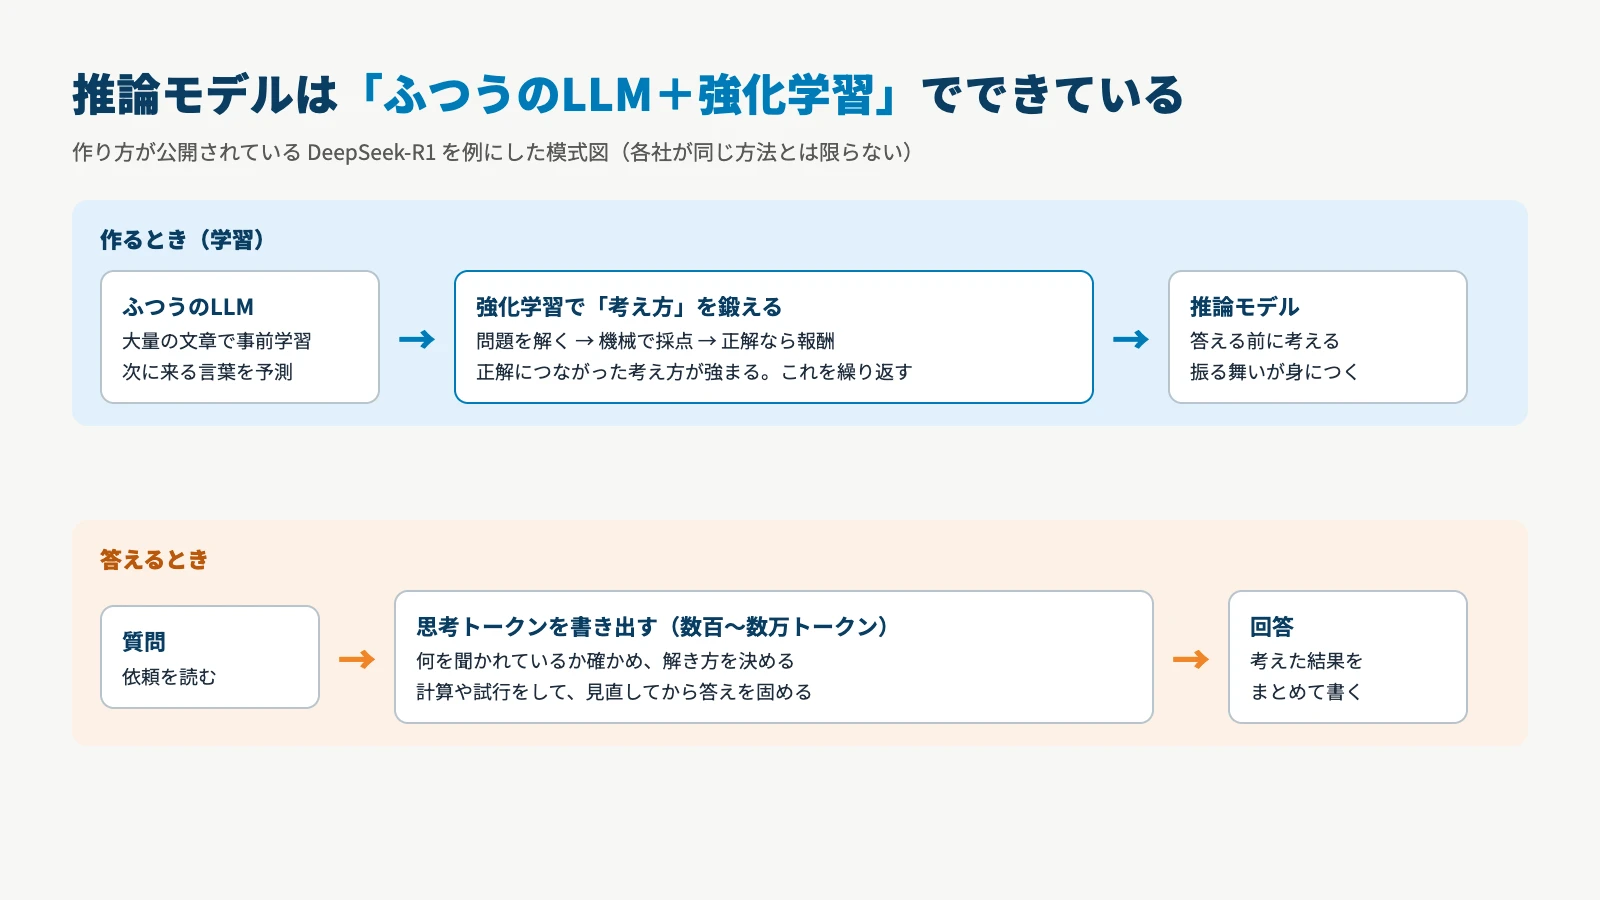
DeepSeek-R1は、通常のLLM「DeepSeek-V3-Base」を出発点にしています(DeepSeek-R1論文)。文章を1語ずつ予測してつむぐ仕組みは、非推論モデルと変わりません。
違うのは、その上にかけた追加の学習です。事前学習の段階で、数学やプログラムの解き方を含む大量の文章に触れているので、モデルはすでに「それらしい解き方」をいくつも出せます。追加の学習は、その中から正解にたどり着く考え方を見つけて強める作業だと言えます。
推論モデルの「考える」は、頭の中で静かに行われる何かではありません。実体は、回答の前に生成される「途中の考え」の文章です。この文章を構成する単位を思考トークン(reasoning tokens)と呼びます。
もとになったのは、2022年にGoogleの研究者が発表したChain of Thought(思考の連鎖)という手法です。例題に途中の考え方を書き添えて渡すだけで、LLMが複雑な問題を解ける割合が大きく上がることが示されました。ただしこれは、人が指示して引き出すやり方です。推論モデルは、指示されなくても自分で途中の考えを書くように学習しています。
DeepSeek-R1-Zero(R1の実験版)では、「まず <think> の中に考えを書き、そのあとに答えを書く」という書式で学習させています。思考の長さは、簡単な問題なら100トークン未満、難しい問題では数千〜数万トークンに及びます。
考え方を身につけさせる方法が強化学習です。うまくいった行動にごほうび(報酬)を与えて、その行動を強めていく学習のことです。
DeepSeek-R1-Zeroの報酬は、驚くほど単純でした。
<think> の中に書いたか)考え方の中身には、一切注文をつけていません。人が書いたお手本の解き方も見せていません。それでも学習を進めると、思考は自然に長くなり、数学のスコアが大きく向上しました。
ChatGPT・Gemini・Claudeの画面には、考えている途中の様子が表示されることがあります。ただし、3社とも表示されるのは要約で、生の思考そのものは見せていません。
一方、DeepSeekのチャット画面では、DeepThink(ディープシンク)をオンにすると、整える前のメモに近い形で思考が表示されます。図1と同じ割引計算を聞いたときの画面がこちらです(2026年10月4日に実施)。
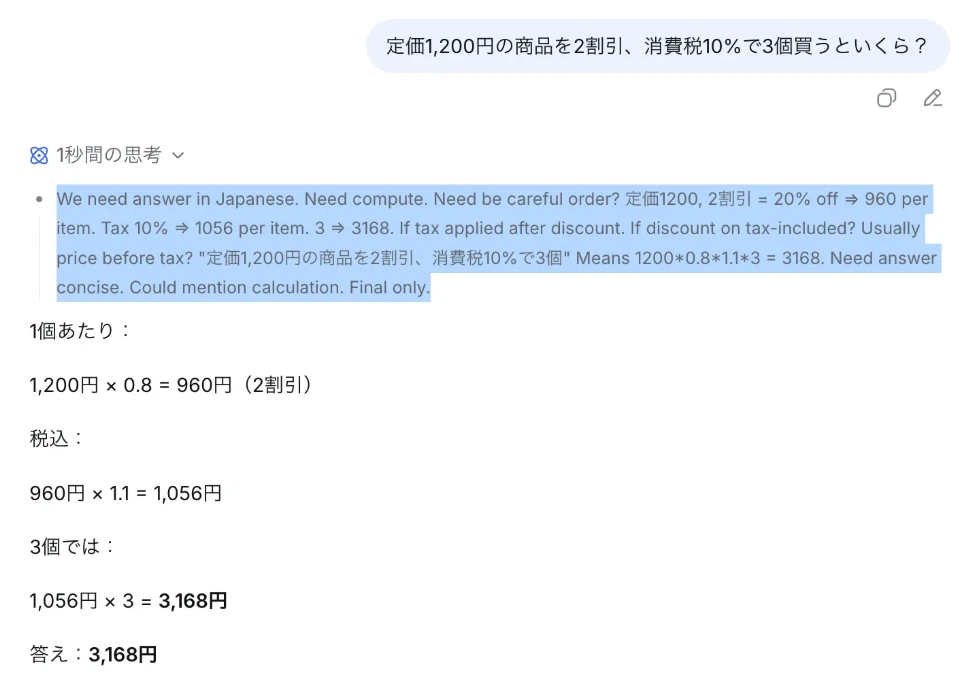
表示された思考(原文):
We need answer in Japanese. Need compute. Need be careful order? 定価1200, 2割引 = 20% off ⇒ 960 per item. Tax 10% ⇒ 1056 per item. 3 ⇒ 3168. If tax applied after discount. If discount on tax-included? Usually price before tax? “定価1,200円の商品を2割引、消費税10%で3個” Means 1200*0.8*1.1*3 = 3168. Need answer concise. Could mention calculation. Final only.
日本語訳:
日本語で答える必要がある。計算が必要。計算の順番に注意? 定価1200、2割引=20%オフ ⇒ 1個960。税10% ⇒ 1個1056。3個 ⇒ 3168。割引のあとに税をかける場合。税込み価格から割り引く場合は? ふつうは税抜き価格では?「定価1,200円の商品を2割引、消費税10%で3個」は 1200×0.8×1.1×3=3168 という意味。答えは簡潔に。計算は書いてもよい。最終的な答えだけ。
日本語で質問しても思考は英語で書かれていること、計算の前に「税込み価格から割り引くのか」と問題の読み方を確かめていることが分かります。
推論モデルの「考える過程」は文章なので、その分だけトークンを使います(トークンの基本は生成AIのトークンとは)。画面には要約しか出なくても、裏では思考の全文が生成されています。この思考トークンが、料金と上限の両方に効いてきます。
OpenAI・Anthropic・Googleは3社とも、APIでは思考トークンを出力トークンとして課金すると明記しています(OpenAI・Anthropic・Google)。画面に出るのが要約だけでも、請求されるのは考えた分の全量です。しかも出力トークンは、入力トークンより単価が高く設定されています。
たとえば、入力100万トークンあたり2ドル、出力100万トークンあたり10ドルのモデル(Claude Sonnet 5.5やGPT-6.1 Solの標準料金)で、同じ質問を非推論モデルと推論モデルで比べてみます。思考の量は問題によって大きく変わるので、ここでは5,000トークンと仮定します。
| 入力 | 思考 | 回答 | 1回あたり | 1,000回あたり | |
|---|---|---|---|---|---|
| 非推論モデル | 1,000トークン | なし | 500トークン | 約0.007ドル | 約7ドル |
| 推論 | 1,000トークン | 5,000トークン | 500トークン | 約0.057ドル | 約57ドル |
画面に出る回答は同じ500トークンでも、費用は約8倍になります。社内の問い合わせ対応など、同じ処理を大量に回す使い方ではこの差が効いてきます。
定額プランでも考え方は同じです。請求額は変わりませんが、考える量が多いほど利用上限に早く達します。
思考トークンは、料金だけでなく「枠」も使います。
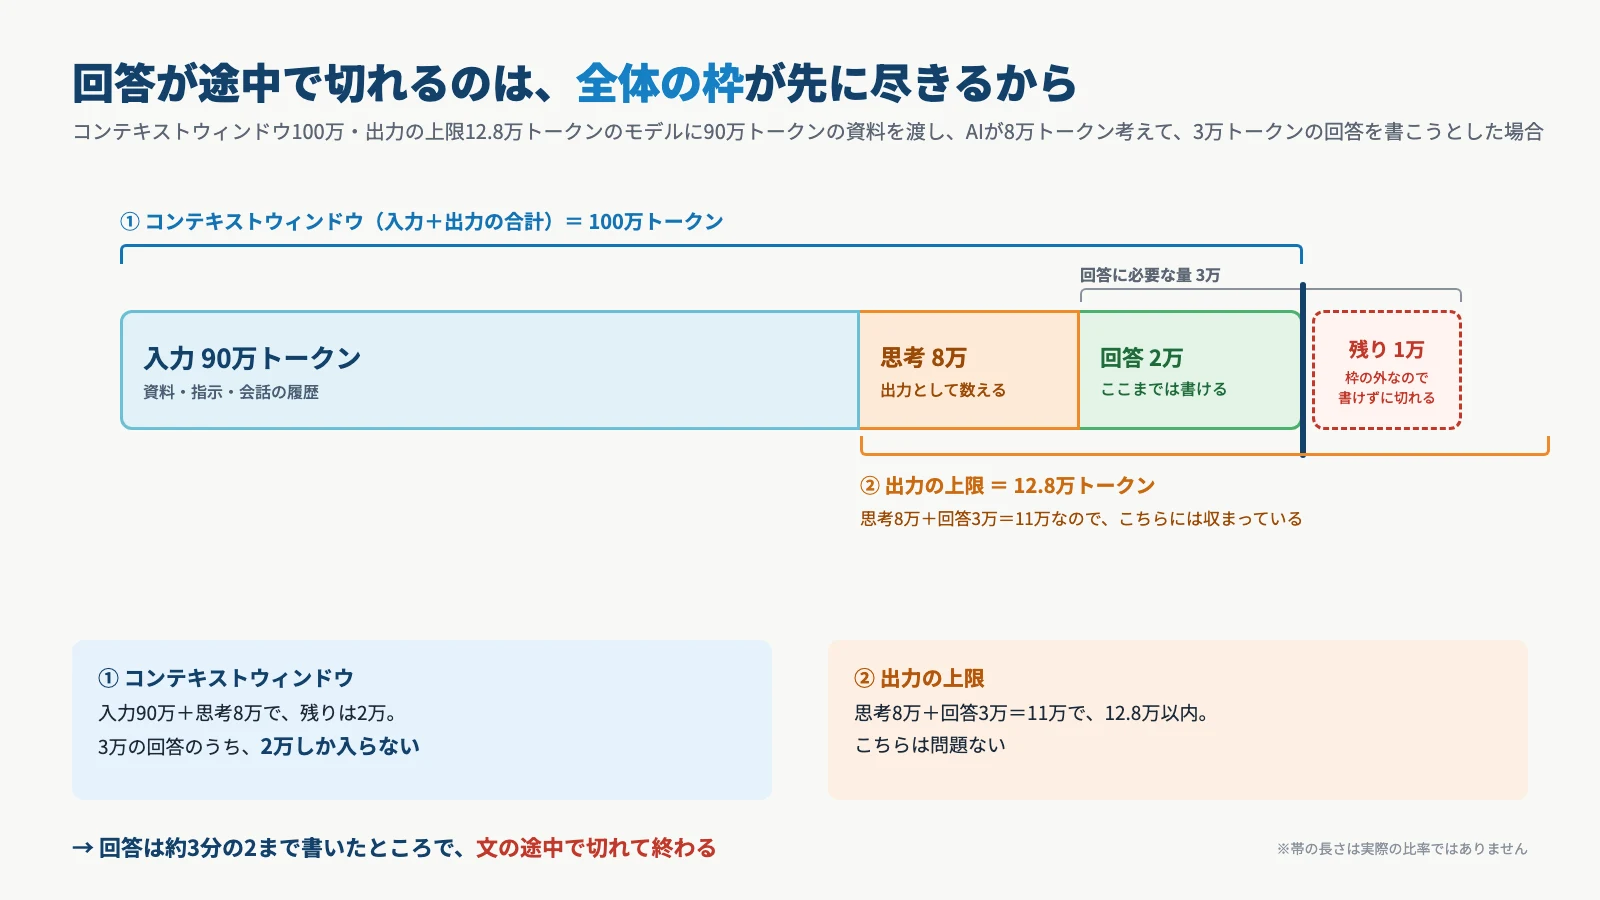
どの枠をどれだけ使うか、枠に収まらないときに何が起きるかは、コンテキストウィンドウとはで図解しています。
少し前までは、「非推論モデル」と「推論モデル」が別々の製品として並んでいました。2026年のいまは、主力モデルのほとんどが「考える能力」を標準で持ち、その量を調整する形に変わっています。だから、日々のAIの選び方は次の2つの軸で決まります。
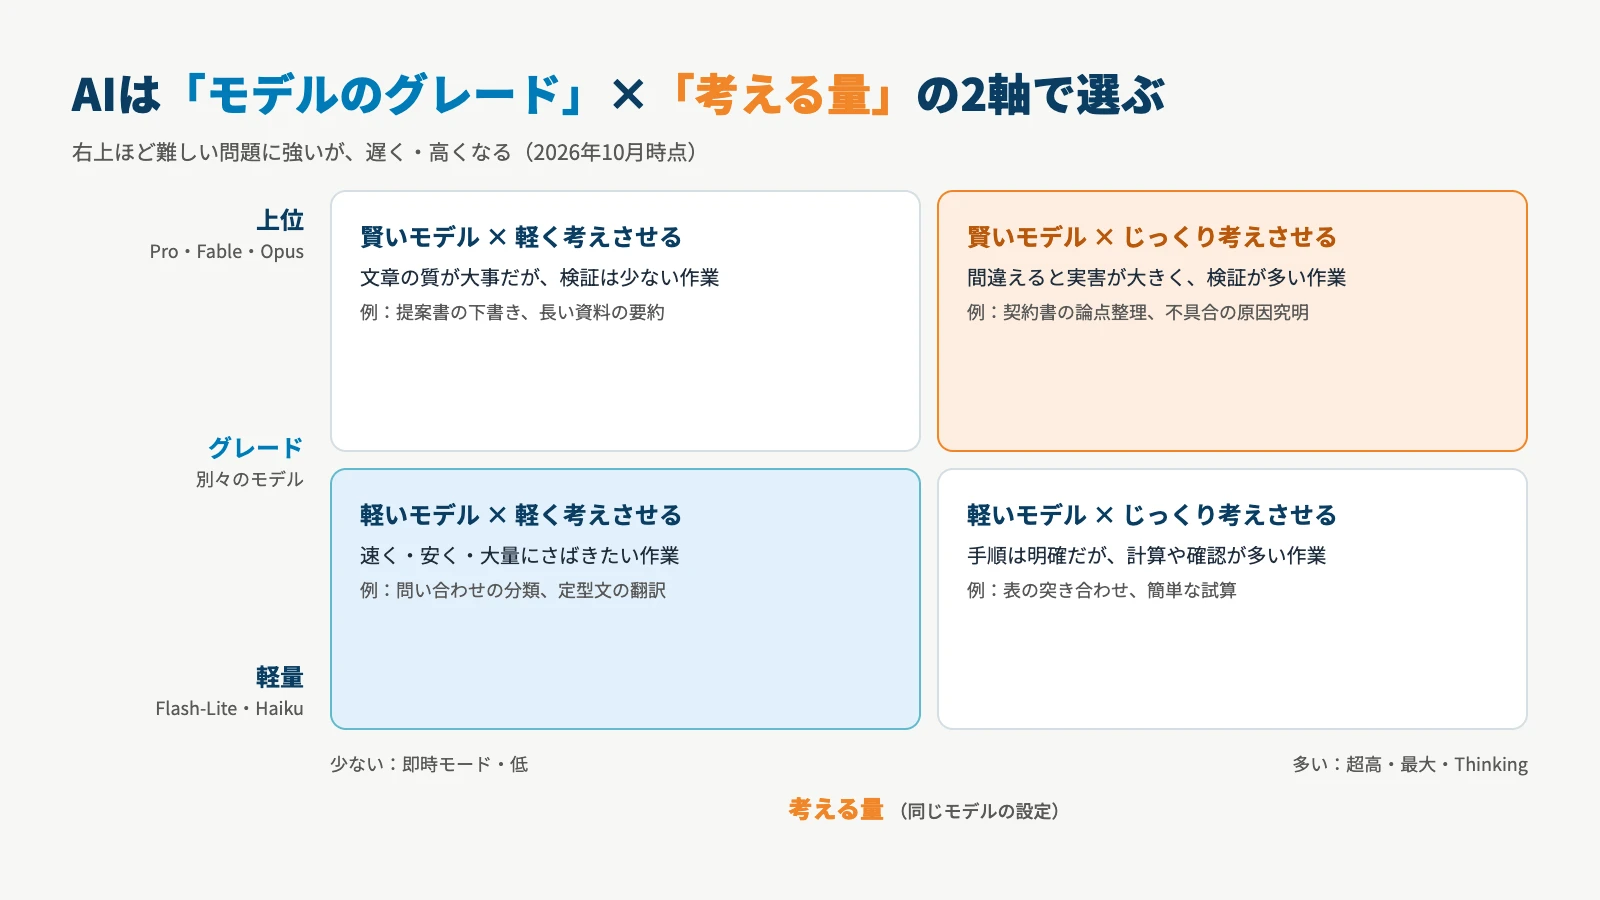
上位グレードほど、そして考える量が多いほど、難しい問題に強くなる一方で、遅く・高くなります(グレードの読み方はAIモデルはどこが進化するのかでくわしく扱っています)。
考える量の設定は、会社によって呼び名が違います。以前は「思考予算(thinking budget)」としてトークン数で上限を指定する方式が一般的でした。いまは3社とも、「低・中・高」のような段階で指定する方式に移っています。
| 会社 | APIでの設定名 | 段階 |
|---|---|---|
| OpenAI | reasoning effort | none/minimal/low/medium/high/xhigh/max(モデルにより一部のみ) |
| Anthropic | effort | low/medium/high/xhigh/max(モデルにより一部のみ) |
| thinking level | minimal/low/medium/high(モデルにより一部のみ) |
もう一つの変化が、考える量をAIが自分で決める仕組みです。Claudeの「アダプティブ思考」は、考えるかどうか、どれだけ考えるかをモデルが依頼ごとに判断します。GeminiのAPIも、既定で複雑さに応じて推論量を調整します。人が指定する段階は、「このくらいを目安に」という指示に近くなっています。
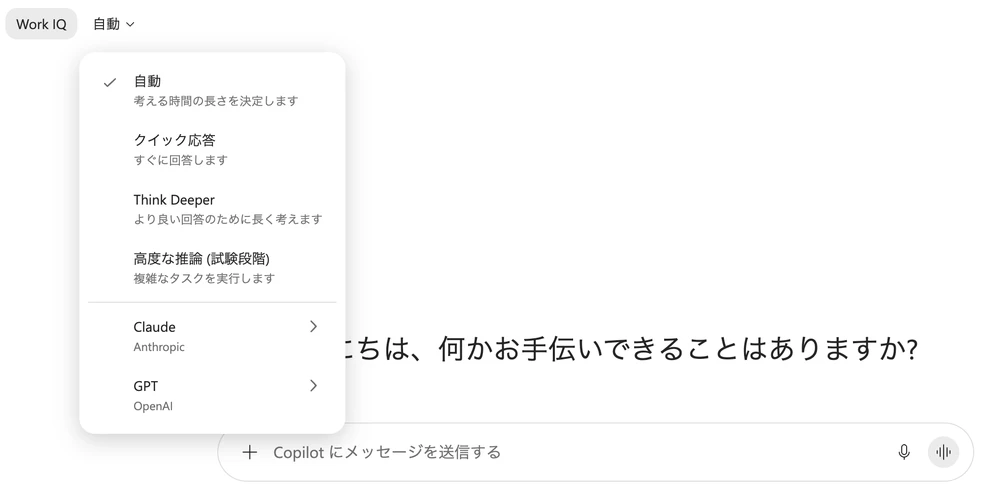
4つのサービスとも、入力欄のまわりにあるメニューから考える量を選べます。画面は2026年10月時点のものです。
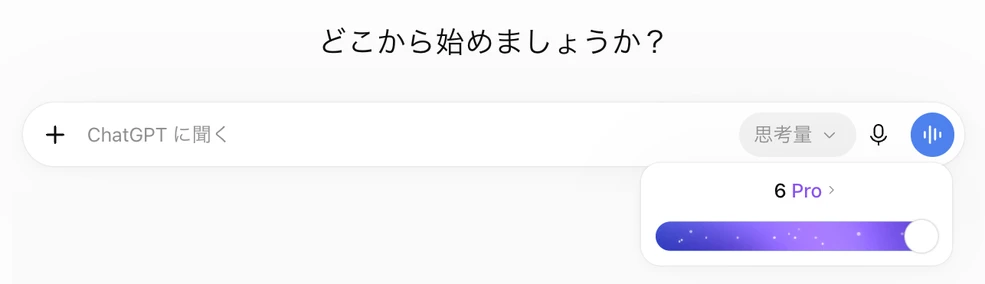
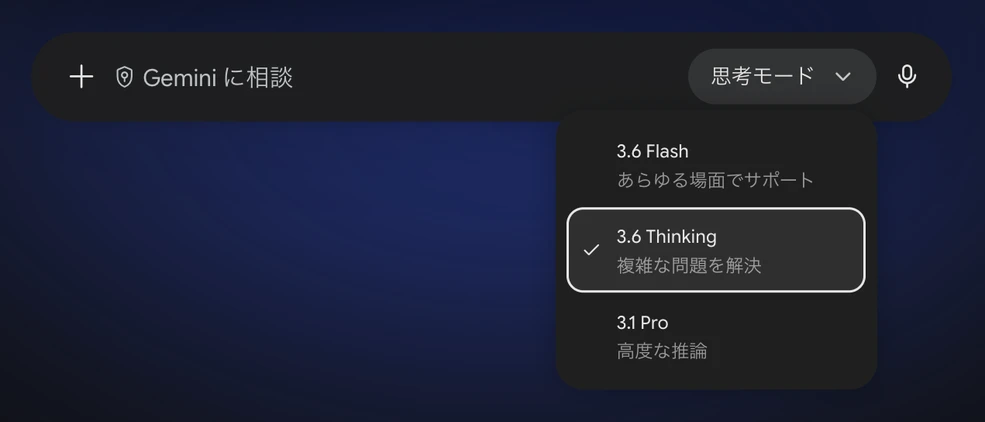
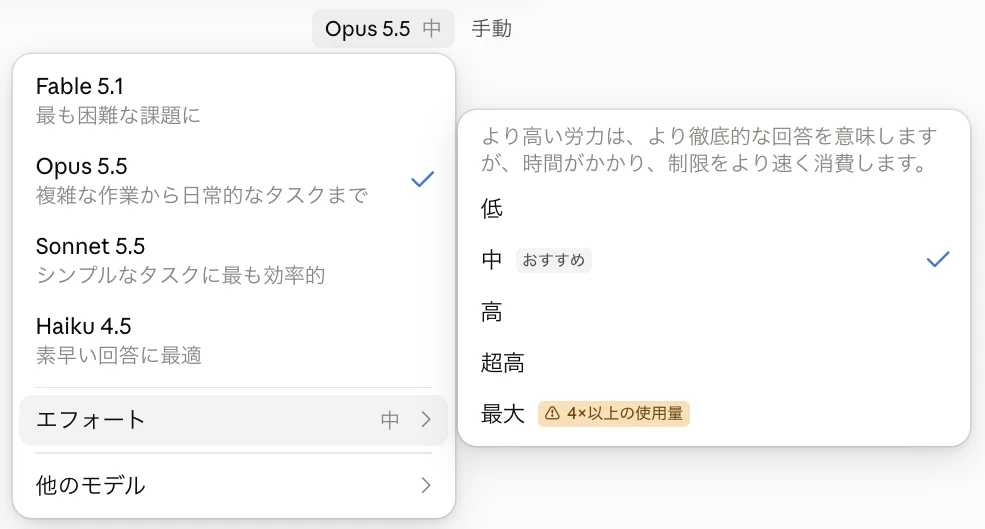
法人向けのMicrosoft 365 Copilot
推論モデルもLLM(大規模言語モデル)の一種です。ふつうのLLMに、答える前に「考える過程」を書き出す振る舞いを追加の学習で身につけさせたものです。対立する概念ではなく、「LLMの中の、考えてから答えるタイプ」と理解するのが正確です。
どちらも推論モデルの別名です。英語の reasoning model を訳したのが「推論モデル」、カタカナにしたのが「リーズニングモデル」です。「思考モデル」は、Geminiの「Thinking」など、各社が「考える」という言葉で機能を呼んでいることから使われています。
APIで使う場合、考えた分の思考トークンが出力として課金されるため、同じ質問でも非推論モデルより高くなります。本文の試算では約8倍でした。ChatGPTやClaudeなどの定額プランでは請求額は変わりませんが、利用上限に早く達します。
いいえ。要約や下書きのような単純な作業では、待ち時間とコストが増えるだけで、精度はほとんど変わりません。簡単な質問で考えすぎて、かえって答えがぶれることもあります。多段階の検証が必要で、間違えると実害が大きい作業に絞って使うのが効率的です。
次にAIを使うとき、「これは“考えさせる”べき作業かな?」と一度立ち止まってみてください。それだけで、精度もコストも無駄が減るはずです。
いずれも2026年10月4日に確認。
論文・研究
各社のドキュメント・ヘルプ

 お役立ち資料